2026
Une plateforme de casting que j'ai conçue, pilotée et livrée de bout en bout
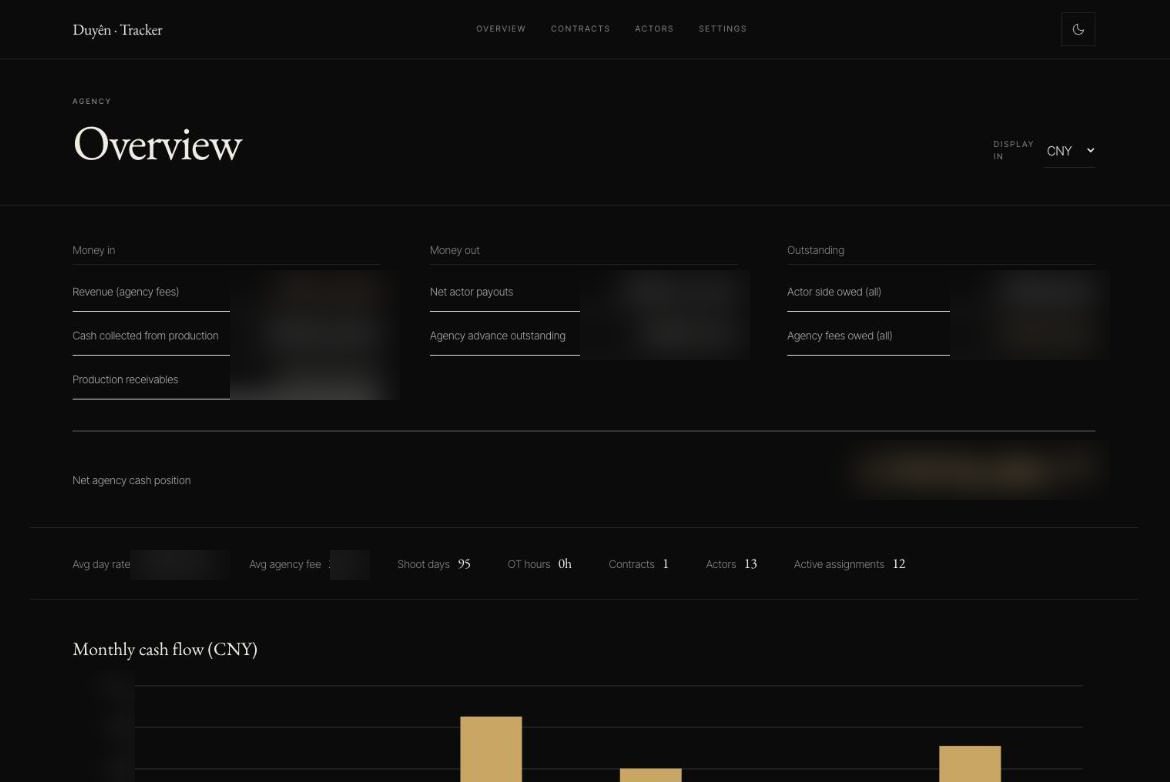
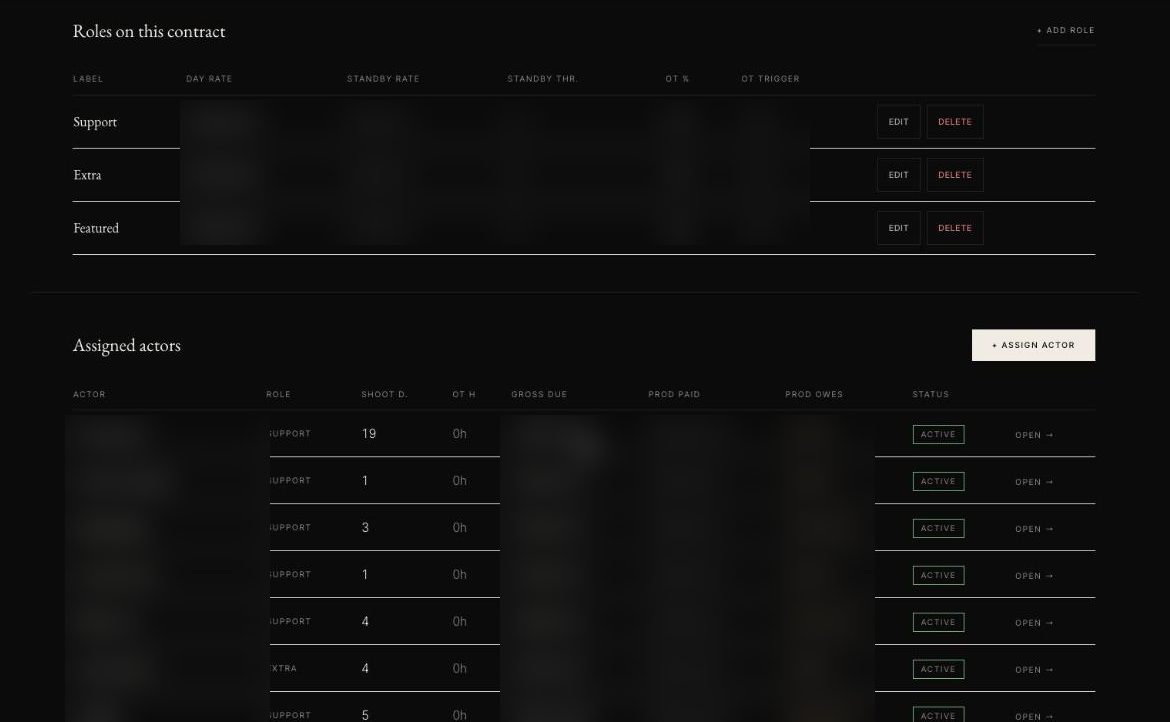
Résultat : plus de 200 acteurs repérés, dont une trentaine retenus dans le roster. Sur The Wandering Earth 3, j'avais placé 13 acteurs pour 95 jours de tournage avec, pour tout outil, des tableurs et des messageries. La plateforme, que j'ai menée de bout en bout, sécurisée et accessible depuis la Chine continentale, existe pour que plus aucune production ne tourne ainsi.
Lire le cas complet
D'où elle vient
Tout part de The Wandering Earth 3. J'y coordonnais le casting étranger d'une production chinoise avec, pour seuls outils, des messageries, des e-mails et des tableurs. Pouvait-on travailler ainsi ?
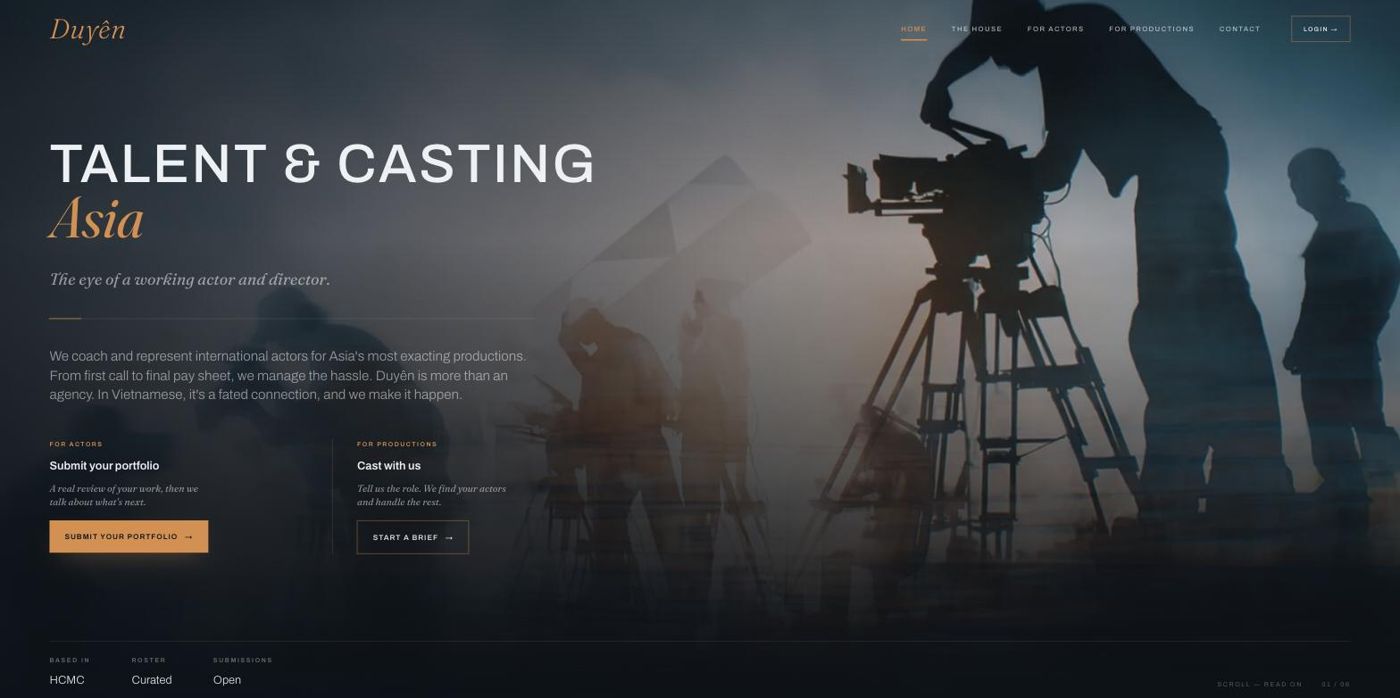
Manifestement, non. Après le tournage, j'ai donc créé une agence pour faire ce travail correctement, puis construit l'outil sur lequel elle repose.
Ce que j'ai bâti
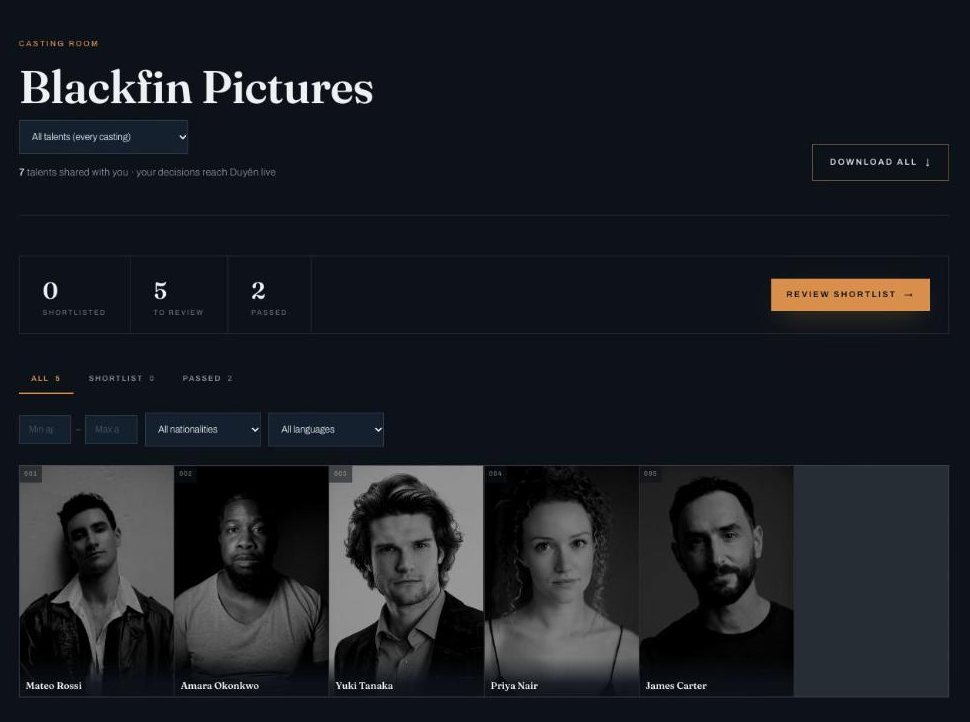
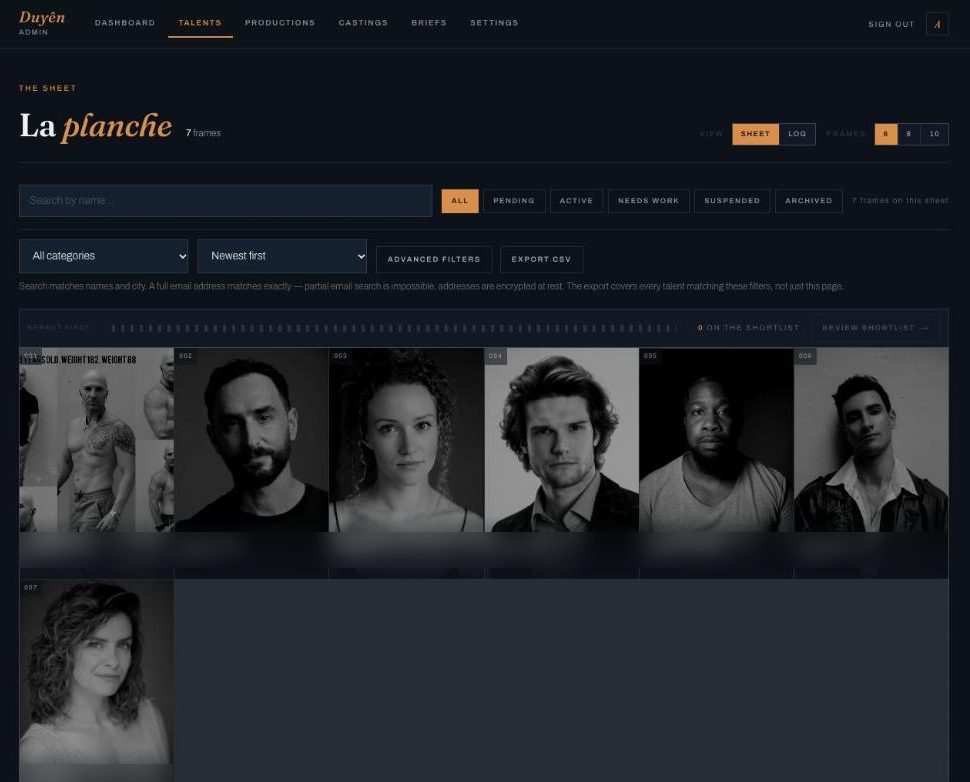
Un roster unique, partagé par trois types d'utilisateurs. D'abord les acteurs, qui postulent et tiennent leur portfolio à jour. Puis l'agence, qui les évalue, les admet et les présente. Enfin les productions, qui ouvrent une salle de casting privée, comparent une présélection et réservent.
Chaque acteur reçoit en outre un CV PDF aux couleurs de l'agence, régénéré dès que ses crédits changent.
Du self-tape à l'acteur payé, une seule chaîne
Un formulaire aurait suffi à un site vitrine. Or une agence de casting a besoin de toute sa chaîne, et chaque partie doit y travailler dans son propre espace.
Acteurs
- Ils postulent, puis téléversent photos, bandes démo et self-tapes.
- Leurs fichiers sont compressés, renommés et rangés automatiquement, afin qu'une production, où qu'elle soit, télécharge vite un dossier propre et structuré.
- Leur ancien CV est lu, analysé, puis reconstruit en PDF aux couleurs de l'agence.
- Ils ont un espace personnel et des outils à eux : un lien de profil qu'on a envie de partager, des comp cards en un clic.
Agence
- Elle parcourt tout le roster en quelques secondes.
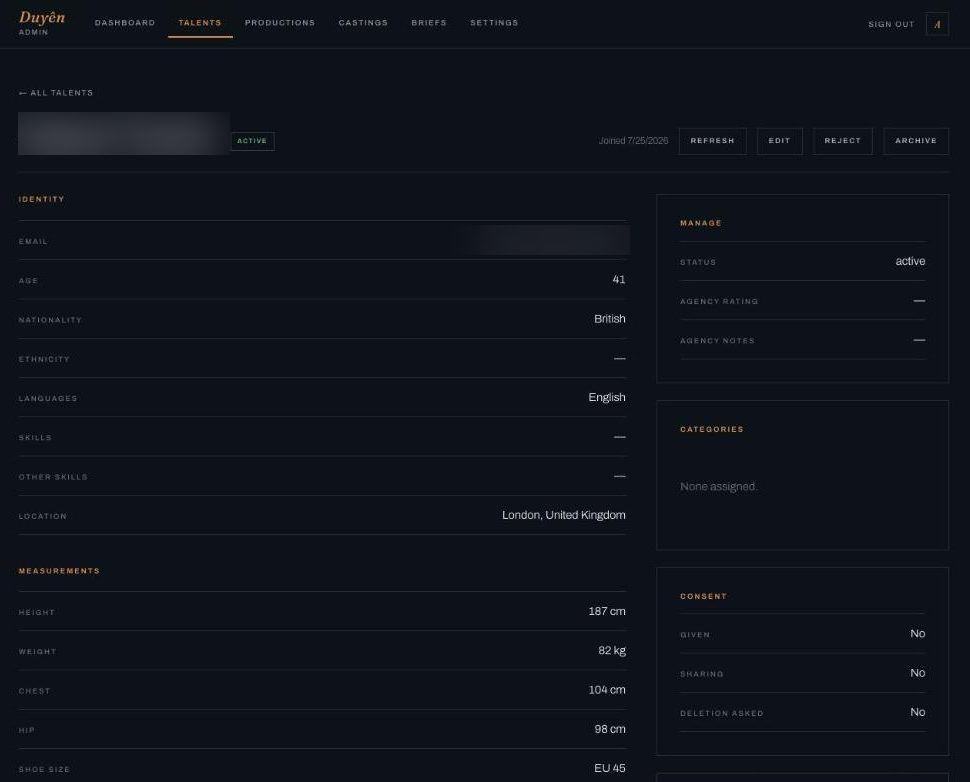
- Elle évalue les acteurs, les admet, puis les accompagne dans leur développement.
- Pour chaque casting, elle constitue une sélection et l'envoie à la production.
- Elle reste le filtre entre les deux parties : rien n'atteint un acteur sans notre validation.
Productions
- Elles reçoivent la sélection dans une salle de casting privée, où tous les CV sont aux couleurs de l'agence.
- Elles retiennent ou écartent chaque acteur.
- Elles réservent les acteurs retenus et signent les contrats sur la plateforme.
- Elles suivent chaque acteur, de la présélection au plateau.
Précision : tous les écrans de la plateforme affichent ici des données de démonstration.
Où est la difficulté ?
Trois parties pour une seule vérité
Acteurs, agence et productions voient chacun une part différente des mêmes données. Qui voit quoi, et à quel moment ? Voilà, au fond, le produit. Ainsi, un acteur ne doit jamais apprendre la décision d'une production avant que l'agence ne l'ait validée, et le nom d'une production n'est révélé qu'avec son accord.
Un marché de l'autre côté du pare-feu
Or les productions travaillent depuis la Chine continentale, où Supabase est bloqué et où la plupart des hébergeurs sont absents. D'où le réseau de Cloudflare devant un serveur à Singapour, préféré, pour la latence vers le Vietnam, à un serveur allemand moins cher.
Des fichiers lourds
Bandes démo et self-tapes sont de gros fichiers vidéo. Il a donc fallu des téléversements reprenables vers le stockage, une chaîne d'encodage vidéo et des liens signés à courte durée.
Des données personnelles
Coordonnées, origine ethnique, mensurations, photos, notes privées de l'agence : une fuite exposerait les acteurs et la confiance des productions envers l'agence. C'est pourquoi la sécurité reste le seul domaine où je n'ai jamais rien sacrifié à la vitesse.
Sécurité
J'ai d'abord écrit des règles de sécurité que l'IA n'a pas le droit de contourner. J'ai ensuite fait relire le code en plusieurs passes, puis de nouveau après chaque fonctionnalité. Quinze fiches de décision portent d'ailleurs sur la sécurité et le durcissement.
- Le serveur reste invisible. Son adresse se cache derrière Cloudflare, et il refuse toute connexion qui ne prouve pas venir de notre propre domaine.
- Au repos, les champs sensibles sont chiffrés. Notes et évaluations de l'agence ne quittent jamais l'administration, et le fichier qu'une production télécharge obéit à une liste blanche stricte, sans la moindre coordonnée.
- Une connexion unique pour tous, avec un message d'erreur générique. Impossible, donc, de tester si un compte existe. Les sessions sont courtes, renouvelées à chaque usage, et le verrouillage contre la force brute ne se contourne pas en falsifiant son adresse.
- Les sauvegardes sont chiffrées avant même de quitter le serveur, et leur clé est gardée à l'écart du stockage qu'elles protègent.
- Enfin, les formulaires publics sont protégés des robots, les vulnérabilités des dépendances triées, les outils de build figés sur des versions exactes.
Un agent IA écrit vite et parle avec assurance. Mon travail a donc surtout consisté à repérer où il se trompait avec aplomb.
Travailler avec des agents IA : ma méthode
Premier constat : un agent IA écrit du code plus vite que je ne peux le vérifier. Le goulot d'étranglement a donc changé de place. Or les pièges sont connus : du code qui a l'air juste, des faits inventés, du contexte perdu, des coûts qui s'emballent. Pour chacun, j'ai mis en place une parade.
Vérification
Une tâche « rends cette page responsive » m'était livrée comme finie ; sur mon téléphone, j'y trouvais pourtant encore sept défauts, un par un. J'ai donc écrit un guide de vérification que chaque session suit avant de dire « terminé ». J'ai aussi découvert 883 tests que rien n'exécutait avant la mise en production, et je les ai fait brancher. Un audit avant lancement a malgré tout repéré 3 points bloquants qu'aucune vérification automatique n'avait vus.
Faits inventés
Livré à lui-même, un agent comble les trous par une fiction plausible : d'anciens clients qui n'existent pas, des chiffres rassurants, des photos de banque d'images présentées comme nos acteurs, des liens de profil qui mènent à quelqu'un d'autre. D'où une règle : ce que je ne peux pas prouver ne devient pas public. Les textes vivent dans des documents qui m'appartiennent, et une maquette n'a pas le droit d'ajouter une affirmation. De même, les données pour les moteurs de recherche ne contiennent que des liens fournis par moi. Quant aux photos provisoires, elles font désormais échouer le build.
Mémoire
À chaque session, un agent repart de zéro. Comment travailler dans la durée avec quelqu'un qui oublie tout ? En confiant la mémoire au projet lui-même. Un fichier de briefing énonce les règles en vigueur et renvoie au raisonnement ; plus de 100 fiches de décision en gardent le pourquoi. Un journal d'avancement est tenu après chaque tâche, et une règle écrite interdit de rediscuter une décision tranchée : on peut seulement la réviser formellement. Enfin, un fichier à part liste les « commandes qu'un agent devinerait mal ».
Plusieurs agents à la fois
Je fais tourner plusieurs sessions en parallèle, chacune sur sa propre copie du code. Un jour, l'une d'elles a déployé une copie périmée, effaçant sans bruit la correction d'une autre. Depuis, chaque session mesure au démarrage son écart avec la branche commune, et le script de déploiement refuse tout ce qui n'est pas la dernière version.
Choisir le modèle, compter le coût
Dans le produit, l'import de CV fait appel à Claude. Faut-il pour autant un gros modèle ? Il s'agit de réorganiser du texte, pas d'analyser des images ; j'utilise donc le plus petit, Haiku, et je lui envoie le texte extrait, jamais le PDF brut, qui coûterait bien plus cher. Soit environ 1,5 à 2,3 centimes par import, plafonné à 10 par heure et par visiteur. Chaque réponse est revalidée contre un schéma strict ; si l'IA échoue, l'import fonctionne malgré tout. J'ai aussi chiffré une couche d'IA pour la carte du code, avant d'y renoncer.
Architecture : apprendre d'abord, choisir ensuite
On m'a proposé une première stack ; je ne l'ai pas prise. J'ai demandé à l'IA de m'expliquer les principales options d'architecture et leurs compromis, j'ai tout lu, puis j'ai tranché moi-même. Chaque proposition, je l'ai poussée dans ses retranchements : pourquoi, comment, en combien de temps, dans quelles conditions, pour combien d'utilisateurs ? J'ai dimensionné pour la charge réelle plutôt que pour une échelle hypothétique ; un seul serveur avec l'encodeur vidéo l'a donc emporté sur des services managés plus chers. Et puisque les productions sont derrière le pare-feu chinois, tout ce qui y est bloqué était exclu, quelle que soit sa réputation. Il m'arrive aussi de trancher contre la première proposition quand elle est fausse : un message « vous êtes présélectionné » resté visible alors qu'une production avait écarté l'acteur, un analyseur de CV qui changeait mes 28 crédits en 50, un formulaire de brief qui n'enregistrait rien.
Ce que voit l'utilisateur, l'IA ne le voit pas
Sur mon iPhone, dans le navigateur Arc, le bas de la page d'accueil disparaissait sous la barre flottante. Aucun test ne l'avait vu, et l'IA ne peut pas ouvrir Arc. Trois fois, elle a tenté de deviner la hauteur de la barre en changeant les éléments affichés ou masqués ; trois fois, j'ai testé sur le téléphone et refusé, car une version était trop chargée, une autre supprimait l'indice de défilement que je voulais garder. La solution est venue d'une reformulation du problème : je ne voulais pas moins d'éléments, je voulais que l'indice se pose exactement sur le bord de la barre. Autrement dit, un seul chiffre à régler. Nous l'avons lu sur ma capture d'écran, et au quatrième essai je l'ai validé sur l'appareil.
Même ses outils se trompent
Premier constat : la carte du code que chaque session lisait au démarrage se composait à 54 % de bruit issu de dépendances tierces. Second constat : le chien de garde du build surveillait le mauvais processus, et se trouvait à 0,9 point de tuer un build sain. C'est pourquoi, avant de faire confiance à un outil, je le fais mesurer.